GitHub 上每天都会冒出很多新项目。
大多数我都会看过就忘。
有些看起来很酷,但装完就吃灰。
还有一些,会让我真的想留下来继续折腾。
我想把这些项目记录下来。
不追求“最火”。
只记录那些:
让我真正想装下来试试的东西。
1. skill-cleaner
项目名:skill-cleaner
GitHub 仓库地址: https://github.com/steipete/agent-scripts/tree/main/skills/skill-cleaner
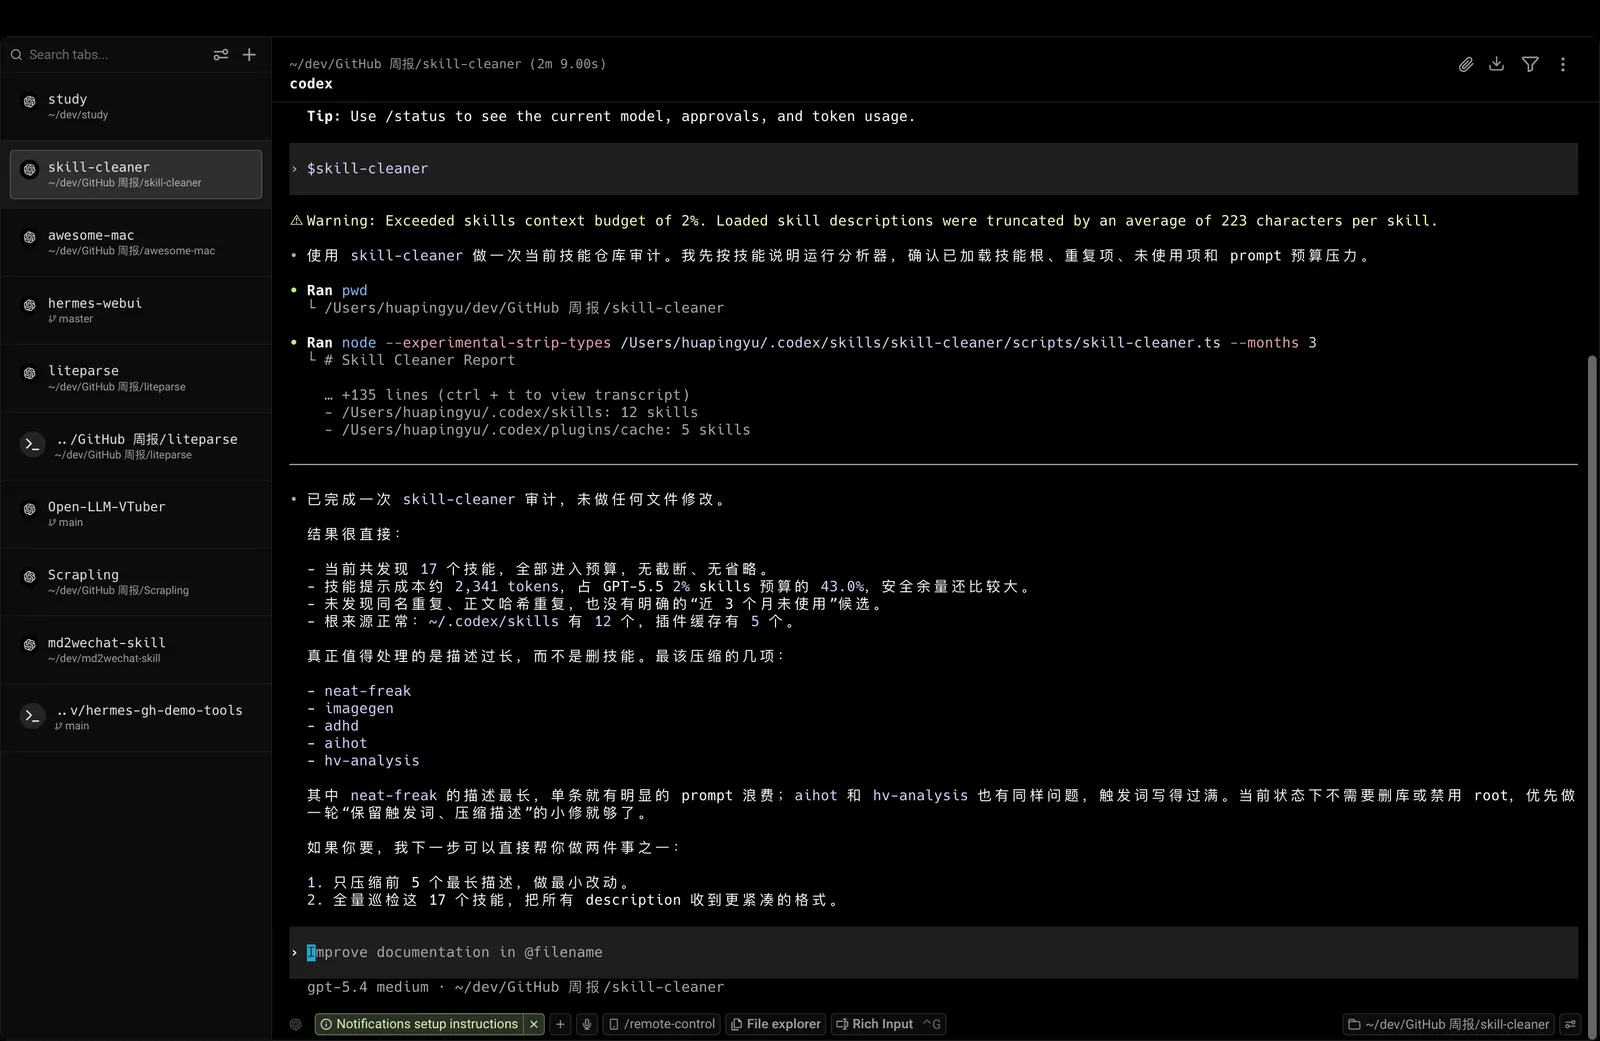
这是 “龙虾之父” Peter 开源的一款 skill-cleaner 工具,用于诊断和优化AI智能体的技能提示词
该工具包含 5 项核心功能,包括技能提示词预算审计、重复技能检测、未使用技能筛查、技能根目录审计和描述精简优化,旨在帮助减少冗长描述对token 预算和上下文窗口的占用
简单来说的话,这个 skill 就是给 Codex / Claude Code 等可以调用 Skill 的工具所做的一个体检,用来判断技能库是否臃肿、重复、闲置,或者过度占用 prompt 预算,毕竟 skill 就像是数据库的索引一样,不是越多越好的
如果你有以下的几个痛点,那么这个 skill 是值得你一试的
- 想把 skill description 压短,但不想盲改
- 想做一次技能库治理,而不是凭感觉删改
- 同一能力被反复封装,担心出现重复 skill
- skill 数量越来越多,开始怀疑上下文被挤占
- skill 来源变杂,不清楚系统内置、插件、个人目录、仓库目录到底谁在生效
2. 洁癖 skill
项目名:neat-freak
GitHub 仓库地址: https://github.com/KKKKhazix/khazix-skills/tree/main/neat-freak
你在使用 AI Agent 的时候有没有觉得 Agent 越用越笨,这其实是上下文已经出现 “脑腐” 了
代码改了七八轮,README 还是 1.0,CLAUDE.md 还在写旧架构,记忆文件里甚至保留着已经废弃的约定,这种情况下,Agent 还能很聪明就奇怪了
这个 skill 在做的一件事情就是:让项目知识和项目进度保持一致性
每次功能开发完,运行一次 /neat,它会自动巡检 docs、CLAUDE.md、记忆文件,识别哪些信息已经过期、冲突、遗漏,然后完成同步、整理和收敛
3. awesome-mac
项目名:awesome-mac
GitHub 仓库地址: https://github.com/jaywcjlove/awesome-mac
你刚买了一台 Mac,或者用了一段时间,却总觉得少了点什么——别人电脑里那些好用的软件,你是怎么都找不到
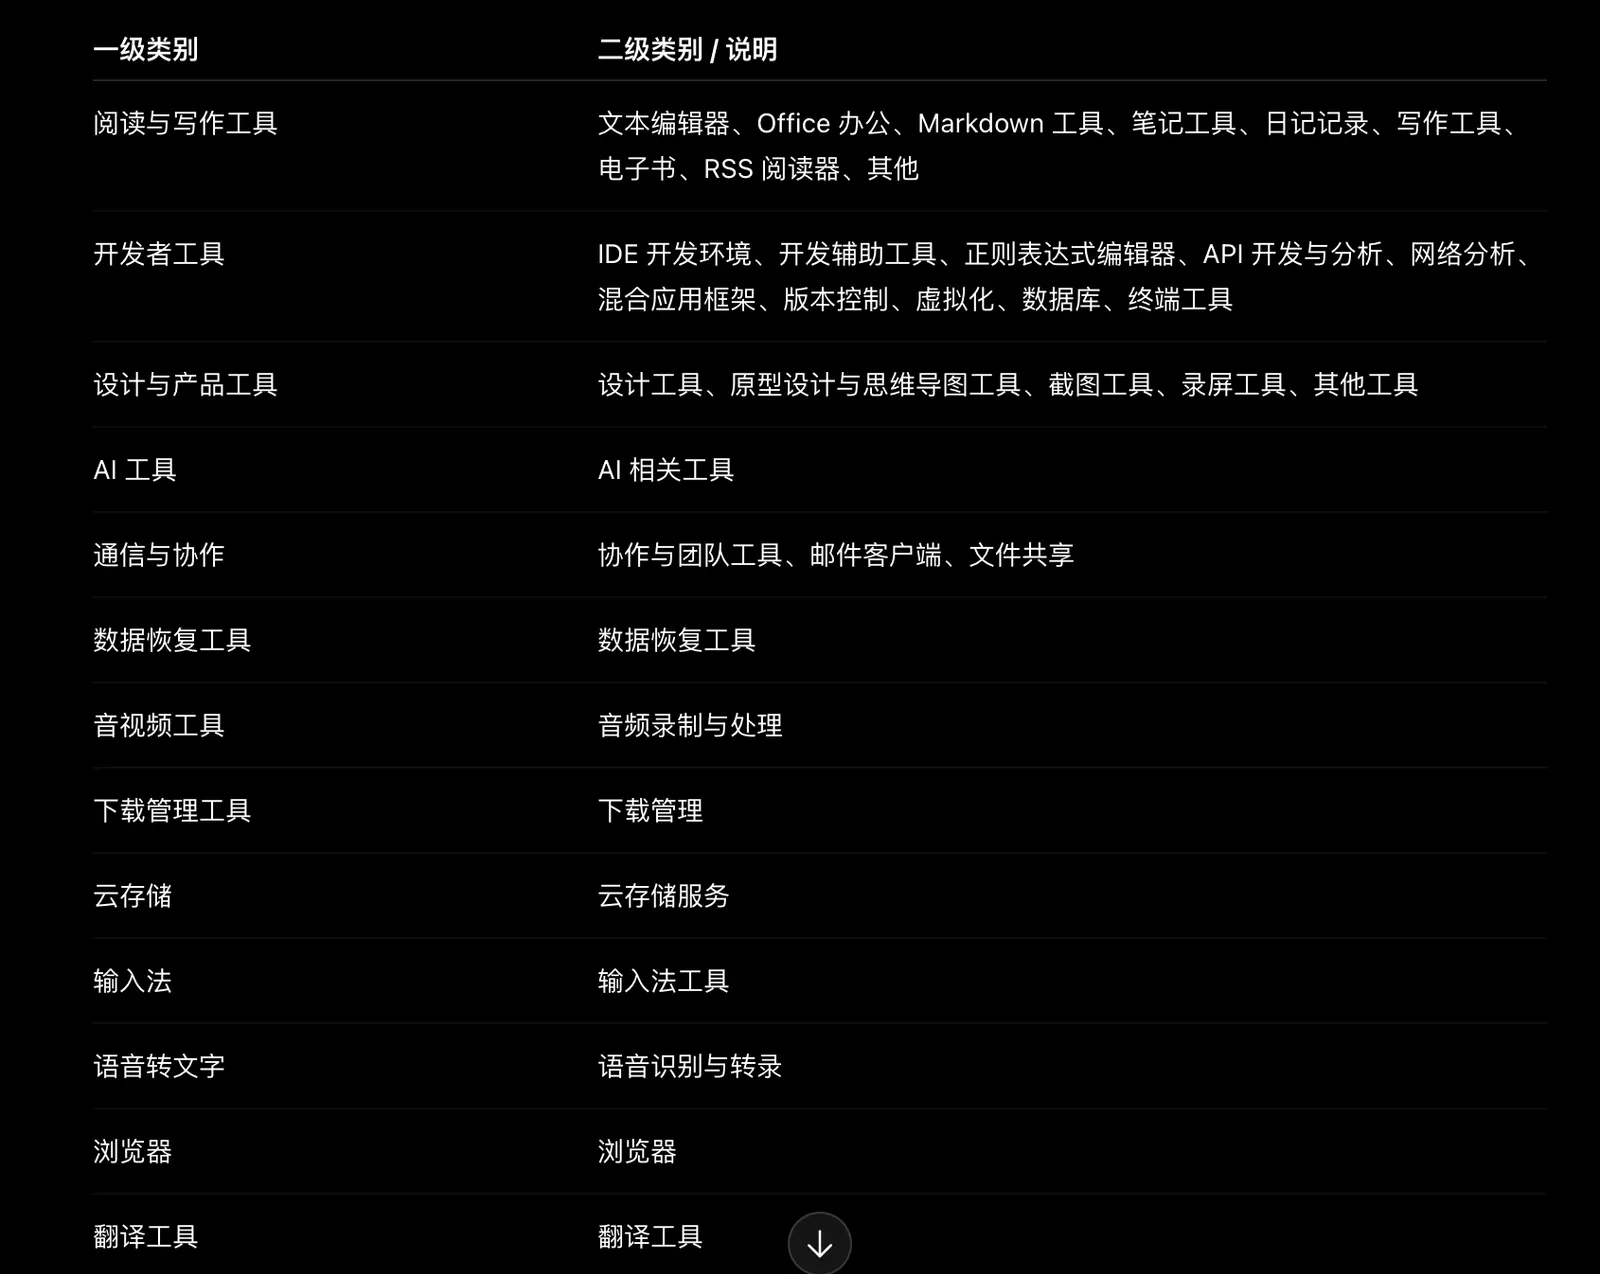
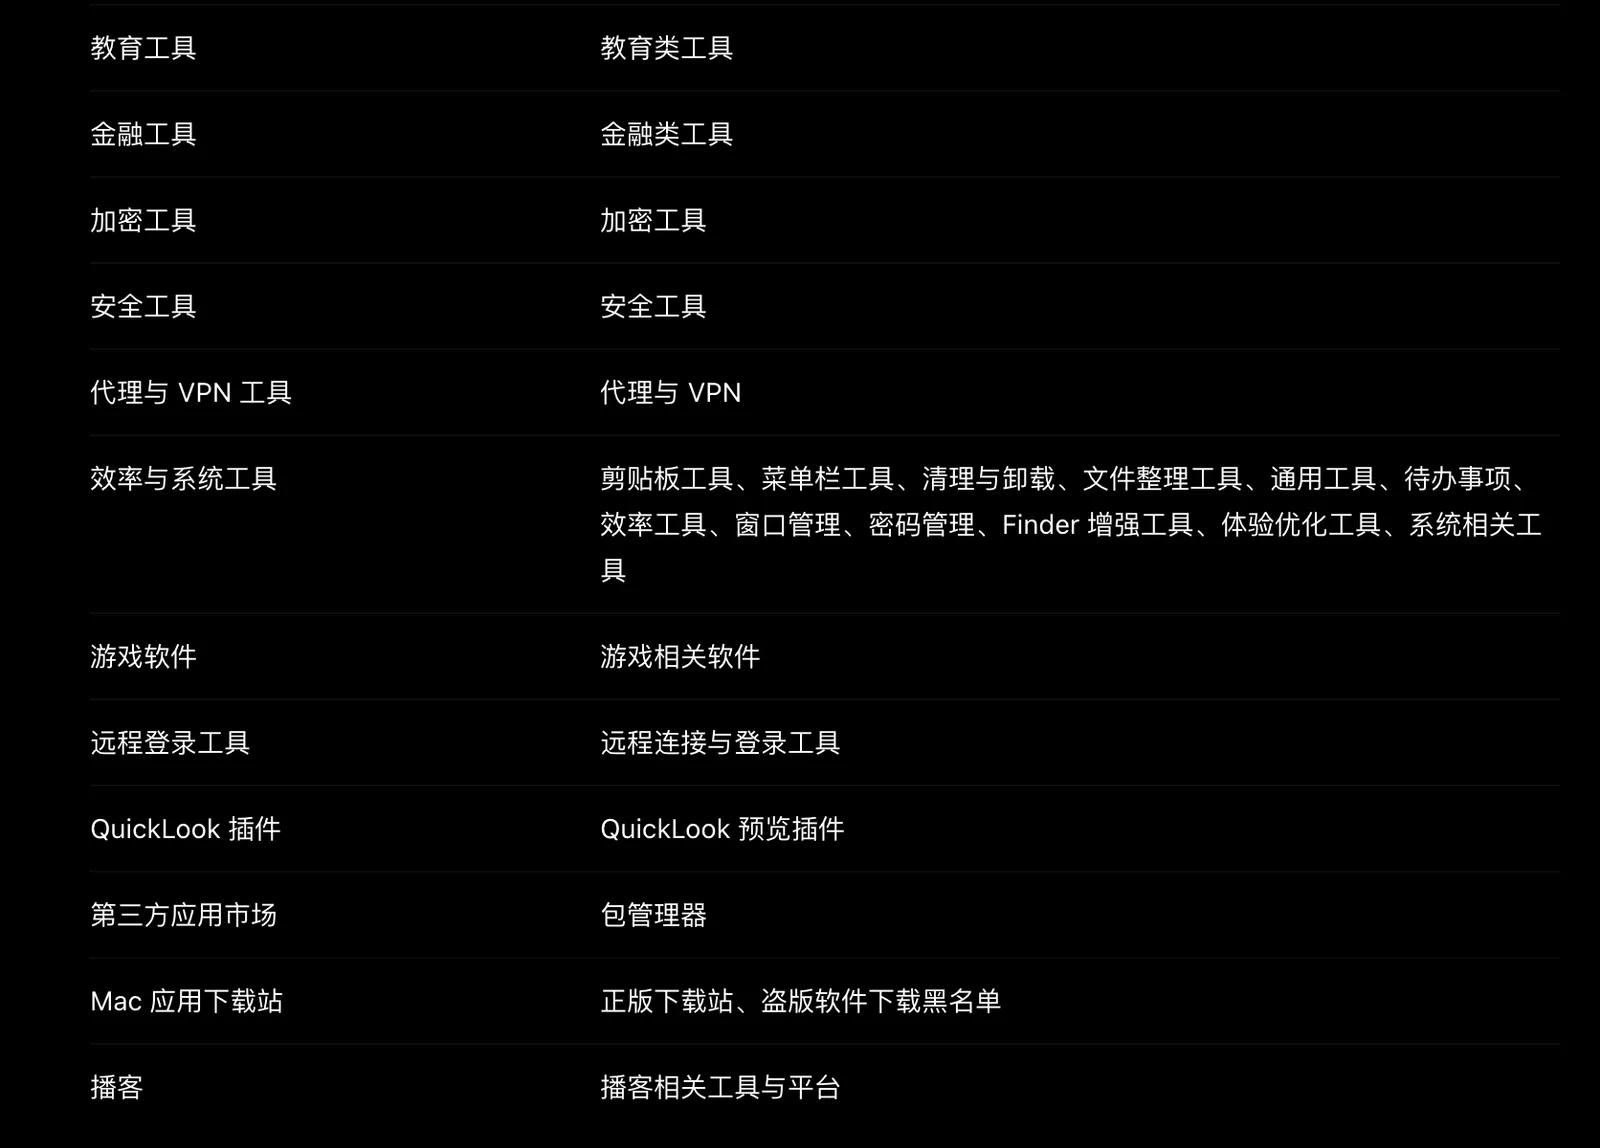
这个项目就是专门帮你解决这个问题的:它把 macOS 上最值得安装的软件,按类别整理成了一份 “购物清单”
具体有哪些类别,下面我整合成了一份表格进行展示
这个仓库有 10 万星标、持续 8 年更新,说明它经受住了时间的考验
但在使用之前我依然需要提一个醒,第一次看这个仓库的时候大概会遇到 “果酱实验”,这里简单提一下「果酱实验」
果酱实验(Jam Study)是心理学中著名的 “选择过载” 实验
研究人员在超市分别设置了 24 种果酱和 6 种果酱两个试吃摊位
结果发现,24 种果酱虽然吸引了更多顾客驻足,但真正购买的人却明显更少;而 6 种果酱的购买转化率更高
实验表明:当选择过多时,人们容易陷入比较和犹豫,反而更难做出决定,这种现象被称为 “选择悖论”
所以建议大家在使用的时候,先确定自己要选择哪个分类的应用程序
比如我昨天想要安装一个复制粘贴板相关的应用,就把这个仓库提供给了 Codex,然后告诉它我想要一个复制粘贴板的应用,然后让 Codex 根据仓库的内容进行一个检索来进行应用推荐
当然这里可以继续用自己的一些定制化需求进行筛选效果会更好,关于这个复制粘贴板的应用,最后我选择的是 Maccy,轻量,免费,足够我使用了
4. liteparse
项目名:liteparse
GitHub 仓库地址: https://github.com/run-llama/liteparse
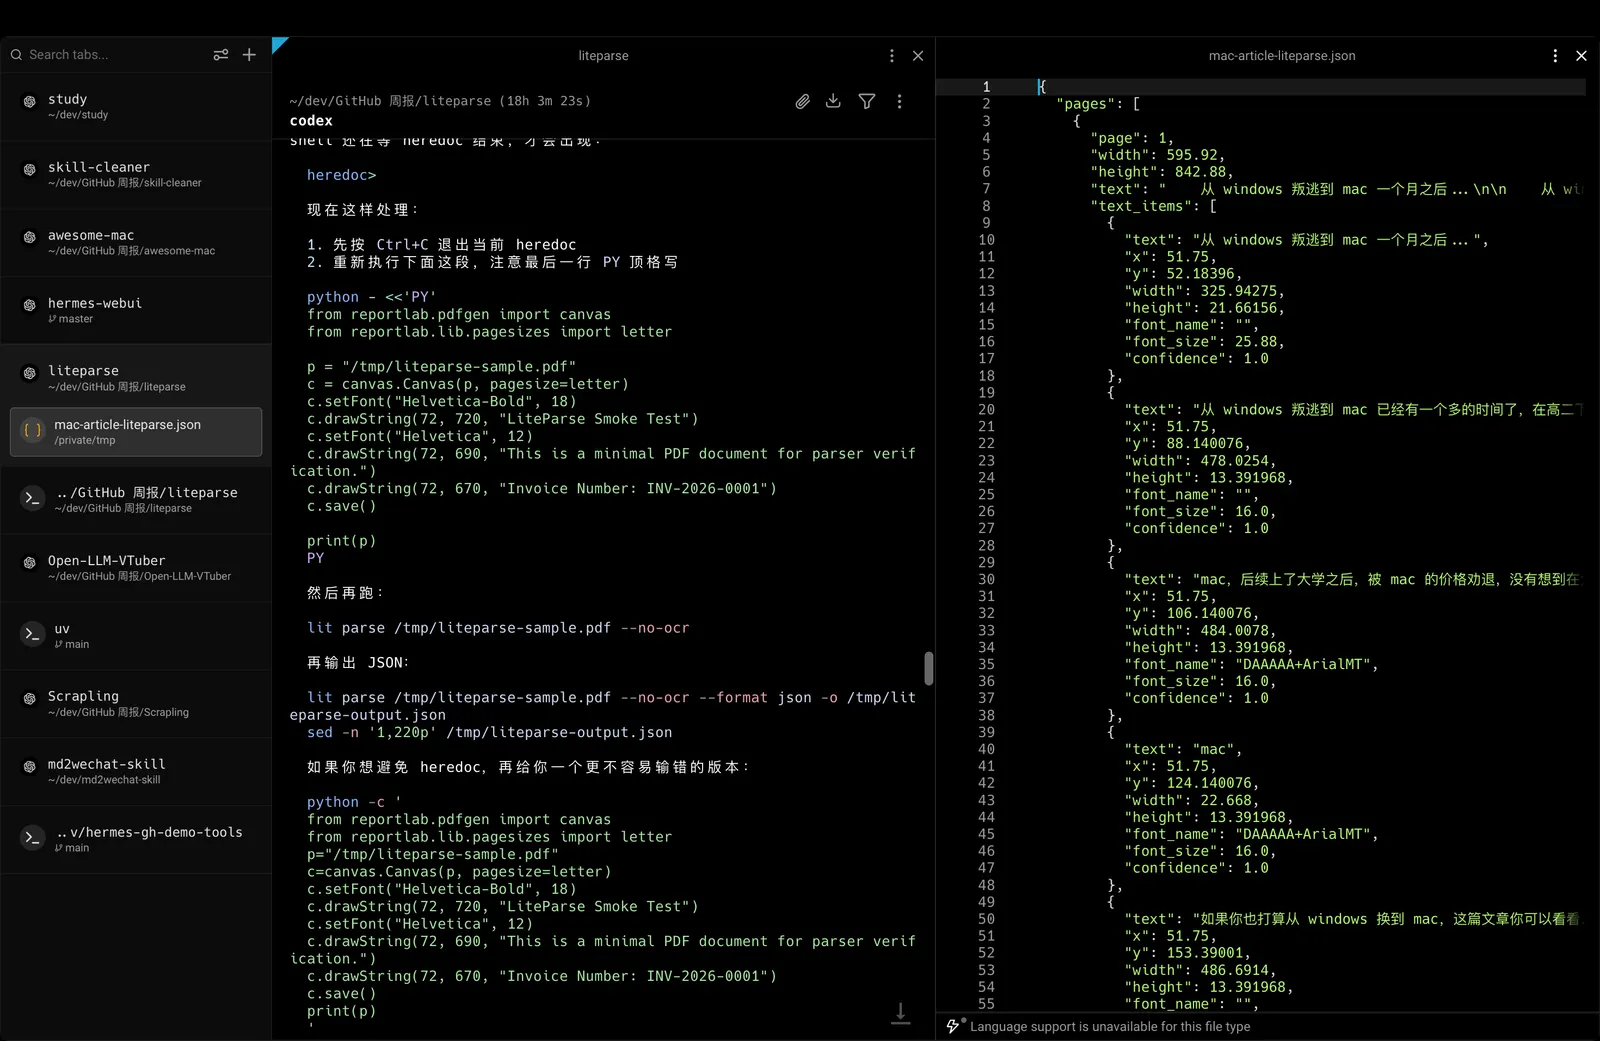
先给这个仓库一句话定位的话,我想是 “将 PDF 文档变成可检索、可定位、可回链的结构化中间结果”,可能是没有听懂哈,说的更直白一些就是可以将 PDF 文档转换成更加适合 LLM 检索的结构化数据
它的输出形态很适合后续程序处理:
- 坐标
- 页级文本
- 块级文本
- 页面截图
- 字体和置信度
这意味着你可以很方便地做 chunk、索引、检索、回溯,而不是每次都把原 PDF 重新丢给模型现场解析
那么这个仓库的核心受众人群就清晰很多了,如果你只是偶尔读一份 PDF,任何工具都行
但如果你要做 RAG、文档问答、证据回链或批量处理,liteparse 这种带版面坐标和截图能力的解析层,价值就明显高于单纯的文本提取工具
还有一点我觉得还是有必要提一嘴的,liteparse 兼顾了文本链路和视觉链路
它不仅能提文本,还能导出页面截图,这很重要,因为现实里的文档经常是 “文本 + 图表 + 图片 + 排版” 混合的。
liteparse 本身不做深度视觉理解,但它把 “结构化文本” 和 “页面图像” 同时准备好了,后面可以无缝接多模态模型
5. hermes-webui
项目名:hermes-webui
GitHub 仓库地址: https://github.com/nesquena/hermes-webui
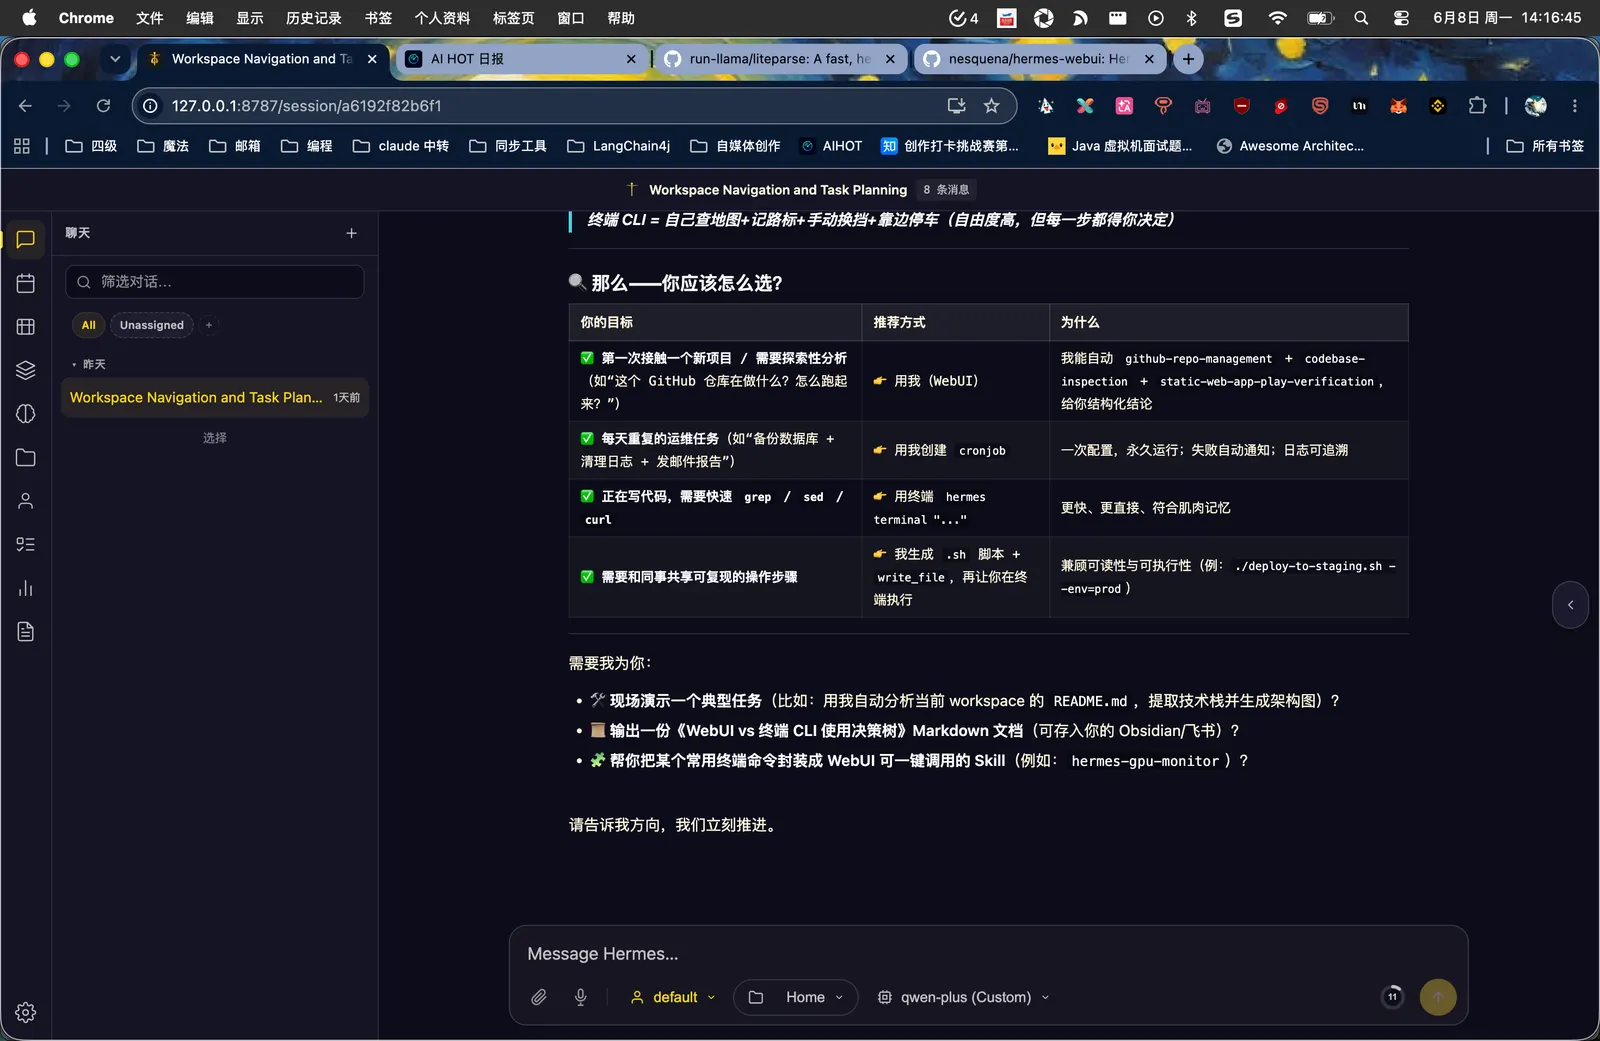
相信 Hermes Agent 大家应该多多少少都是有听说过的,但之前版本的 Hermes 是在终端运行的,这个仓库做的事情其实看仓库名字也很清晰了,为 Hermes 装上了一个漂亮的浏览器界面
从终端换到浏览器界面有哪些好处呢?
首先肯定是会话管理更加方便了,终端天然偏单线程,切换历史上下文、回看旧会话、搜索、重命名、归档,都不如 WebUI 直观;当然也可以采用 Warp 这种 “多线程” 终端,但依然是没有一个浏览器界面的会话管理好用的
接着是信息分区,Hermes WebUI 是三栏结构:会话、聊天、工作区文件。左边切换会话,中间聊天,右边浏览文件,所有设置都在一个圆形菜单里一目了然
还有工具调用的可读性也会更好,tool call、审批卡片、状态提示、错误信息,在 WebUI 里会被结构化展示,不会像终端日志一样混在一起
安全问题也不需要担心,访问地址为 127.0.0.1:8787 这种本地入口,本质上是本机工作台,不是直接暴露到公网
如果你本来就已经将 Hermes 融入到自己的日常工作当中了,那么一个漂亮的前端界面会给你更好的体验的
这个项目在 2026 年 3 月底上线 GitHub,到 2026 年 6 月上旬已经接近 1.4 万星标,增长还是非常快
最后:
后面肯定还会继续遇到:
让我真正想装下来试试的项目。
这个系列也会继续更新下去。
本文首发于知乎 ↗,这里是完整版。